 English
鼎芯评述:IBM 0.7nm纳米堆叠逻辑器件技术突破,给国内逻辑芯片赛道带来哪些启示
在很多工程师的固有认知里,先进逻辑芯片微缩已经摸到物理天花板。本次 IBM 发布的 0.7nm(7 埃)纳米堆叠逻辑工艺,重新拉长了逻辑器件的技术演进周期,也给国内逻辑 IC 厂商的研发和产品定位提供新参考。
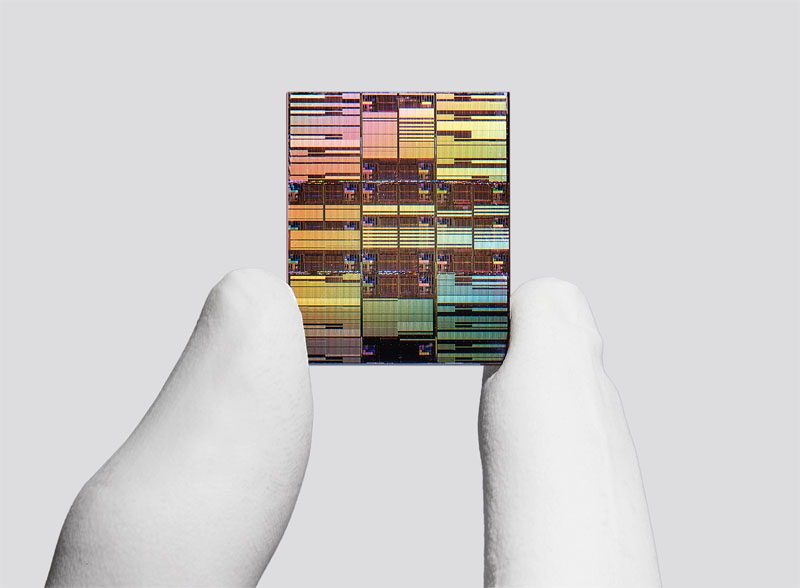
很多人会把这个消息简单理解为 “又一个更小制程”,但核心变化不在数字本身。传统平面、GAA 纳米片架构的微缩红利正在快速收窄,而纳米堆叠的核心思路是垂直分层、异质材料分层优化,不再单纯靠横向缩小栅极。每一层堆叠晶体管可以选用适配的材料,单独调优功耗与速度,这是和现有工艺最大的区别。
从逻辑器件本身看,这项技术优先验证了 CMOS 反相器、SRAM 单元,也就是所有数字逻辑芯片最基础的单元。SRAM 单元面积缩减 40%,对 AI 场景下高速缓存、控制逻辑、接口逻辑的价值非常直接。AI 算力芯片里,大量基础逻辑门、寄存器、时序单元都依赖 SRAM 与标准逻辑单元,存储密度提升会直接降低整体功耗。
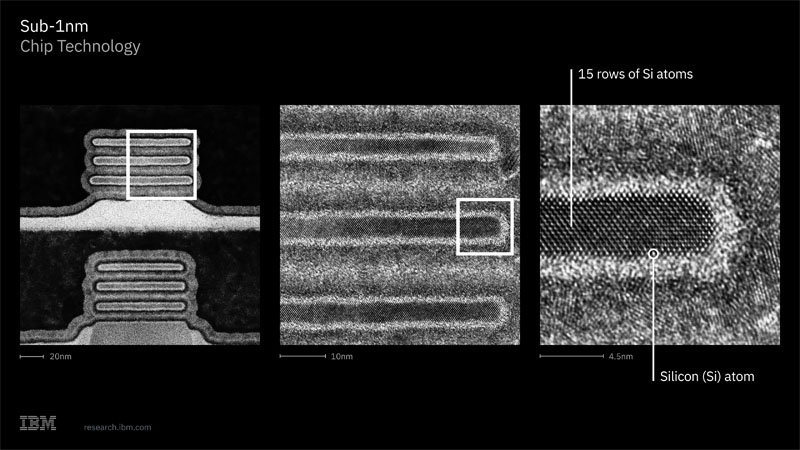
但我们也要客观区分实验室验证和量产的距离。IBM 明确给出的预期是最早 5 年才有可能落地量产,High NA EUV 设备、晶圆键合、超薄介质工艺、良率控制,每一环都有极高门槛。它不是一款马上可以买到的商用逻辑芯片,而是一套底层逻辑工艺架构,会影响未来十年全球逻辑器件的研发方向。
放到国内逻辑器件的赛道来看,先进制程赛道我们短期很难直接对标这条路线。国内厂商的重心,更多集中在成熟节点逻辑器件:通用逻辑门、电平转换、总线收发器、时序逻辑、可编程逻辑等。这也是鼎芯这类国产逻辑器件厂商持续深耕的方向。
成熟节点逻辑器件的市场需求并没有因为先进制程的突破而萎缩。工业控制、安防、家电、新能源 BMS、车载外围控制板,大量板级逻辑、接口逻辑、缓冲驱动芯片,依然以成熟工艺为主。这类场景优先看供货稳定、成本可控、抗干扰、宽温性能,而不是追求极致的纳米节点。
这里也可以看清两条路线的分工:头部大厂走埃级先进逻辑工艺,服务 AI 大算力主芯片;国内国产逻辑芯片厂商,优先补齐成熟节点逻辑器件的供应链短板,做可稳定替代、适配本土客户应用需求的标准化逻辑器件。两者不是竞争关系,是半导体体系里不同层级的配套。
当然,这次突破也给国内研发团队提了方向。未来逻辑器件的创新,不只有 “缩小尺寸” 一条路,三维堆叠、异质集成、分层材料优化,同样是逻辑单元提效的可行路径。国内在封装、异构集成方向积累的技术,后续也可以和逻辑单元设计结合,走出差异化路线。
对于硬件工程师选型来说,短期不用期待 0.7nm 工艺落地到通用逻辑器件。现阶段选型逻辑芯片,依然优先关注静态功耗、传输延迟、驱动能力、ESD 等级、温度范围、供货周期。先进工艺的技术趋势,更多用来做长期产品规划,而不是当下选型依据。
总结来看,IBM 纳米堆叠架构证明逻辑器件微缩还有空间,但先进工艺的落地周期漫长。国产逻辑器件厂商更适合立足成熟工艺,打磨标准化、高可靠的逻辑产品,补齐供应链缺口,服务工业、车载、消费电子等海量板级应用,这也是现阶段国产替代最务实的路径。