 English
理解SPI时序:数据何时有效?
SPI通信里一个经常让人困惑的问题:为什么有的器件要求“先读数据、再给时钟”,而另一些器件需要“先给时钟,才能读到有效数据”?很多SPI教程只罗列4种SPI模式,却很少解释这些模式存在的底层原因。答案的核心,就是搞清楚器件是在哪个时钟节点,把数据送到通信总线上。
本文重点讨论通信双方之间的时序关系。不同MCU内核,配套SPI外设的配置方式会存在差异。
在我近期的项目中,使用了74HC597并行转串行移位寄存器芯片(图1),用于绝对值线性编码器接口。编码器并行采集位置比特,再通过这颗移位寄存器,把位置数据串行输出给Arduino主控。这个工程案例,可以很好地说明时序的重要性,也解释了这类寄存器芯片为什么需要“先读后时钟”的通信逻辑。
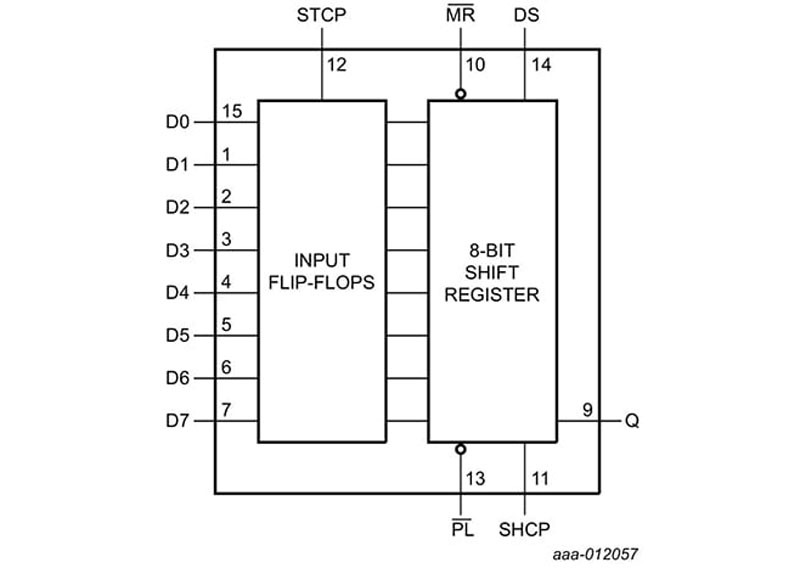
图1 安世半导体(Nexperia)74HC597并入串出移位寄存器功能框图(图源:Nexperia)
本文对比“先读后时钟”和“先时钟后读”两种时序,说明在移位寄存器等器件选型调试时,选对SPI相位(CPHA)的必要性。
一、核心问题:数据何时有效?
和串行外设通信,优先思考的不是:该用哪一种SPI模式?而是:第一个有效数据比特,在什么时候就绪?主流分为两种情况:
1. 先读后时钟(Read-Then-Clock):第一个比特在第一个时钟脉冲到来之前,就已经稳定出现在数据线上(74HC597属于这类)。接收端必须在移位时钟沿到来之前完成采样,否则首比特直接丢失。
2. 先时钟后读(Clock-Then-Read):需要时钟脉冲触发之后,器件才会输出新的有效比特(典型器件74HC165)。接收端必须等时钟沿结束之后,再读取数据。
读懂器件的数据有效时机,就能快速锁定SPI相位;但最终判定,仍然以器件规格书的时序图为准。
二、74HC597寄存器案例说明
74HC597是8位并行输入、串行输出移位寄存器。载入阶段,8路并行输入信号会被一次性锁存进寄存器。
假设并行输入数据:10110010。载入完成后,寄存器内部存储:Bit7=1,Bit6=0,Bit5=1,Bit4=1,Bit3=0,Bit2=0,Bit1=1,Bit0=0。
此时,最高位MSB已经直接送到串行输出引脚。全程还没有产生任何时钟脉冲,首比特已经就绪等待读取。大量并入串出移位寄存器,都具备这个特性。
三、为什么先给时钟会丢失数据?
假设Arduino直接输出时钟脉冲:时钟到来前为10110010;时钟触发移位后变成0110010x。原本的首比特已经被移出寄存器,输出引脚变成原来的第二位。如果MCU在移位之后才采样,首比特直接丢失,最后一位变成未知电平。
读完8个比特之后,预期接收10110010,实际收到0110010x,所有比特整体偏移一位,很多场景下数据完全失效。硬件调试时,遇到比特偏移一位,大概率就是采样时刻和时钟边沿时序不匹配。
四、先读后时钟的工作逻辑
74HC597这类器件的通信流程:读取Bit7→时钟→读取Bit6→时钟→读取Bit5→时钟……每一次时钟脉冲,把下一个比特推到输出端。接收端先把当前已经就绪的比特采样,再触发移位,送出下一位。
硬件SPI实现时,控制器采样边沿必须放在移位边沿之前,才能适配74HC597这类“预输出首比特”的寄存器。
五、软件模拟SPI(Bit-bang)示例
软件模拟SPI时序更容易看懂逻辑,下面是简化版“先读后时钟”代码:
byte value = 0;
for (int i = 0; i < 8; i++) //循环读取8bit
{
value <<= 1; //左移,最低位补0
if (digitalRead(MISO)) //先读取数据线
{value |= 1;}
digitalWrite(SCK, HIGH); //拉高时钟
digitalWrite(SCK, LOW); //拉低,完成一次时钟脉冲
}
循环顺序:先读取数据线,再产生时钟脉冲,然后循环。完美匹配74HC597这类寄存器的行为。
六、先时钟后读类器件
不是所有串行器件都和74HC597一致。很多SPI器件,输出数据是由时钟边沿驱动刷新。这种场景下,必须先给时钟,时钟事件之后,才会出现有效数据:
byte value = 0;
for (int i = 0; i < 8; i++) //循环读取8bit
{
digitalWrite(SCK, HIGH); //拉高时钟
digitalWrite(SCK, LOW); //拉低时钟
value <<= 1; //左移,最低位补0
if (digitalRead(MISO)) //时钟之后再读取数据线
{value |= 1;}
}
流程:先输出时钟脉冲,再读取数据线,然后循环。
七、SPI模式的底层意义
读到这里,SPI四种模式的作用就清晰了。SPI模式,本质就是MCU用来定义:在时钟周期的哪个位置采样数据。理解相位的简单思路:
数据提前就绪:时钟边沿之前,数据已经稳定有效,接收端先采样、后移位。
时钟生成数据:时钟边沿触发器件更新输出,接收端等时钟结束之后再采样。
比起死记模式编号,工程师优先看时序图,判断:首比特是提前就绪,还是时钟来了才出现,就能快速选对相位。
八、SPI模式补充说明
SPI模式由两个参数定义:CPOL(时钟极性)决定时钟空闲状态是高电平还是低电平;CPHA(时钟相位)决定在第一个时钟边沿采样,还是第二个边沿采样。
对于移位寄存器应用,CPHA是最关键参数,它决定采样发生在移位边沿之前还是之后。数据提前就绪的器件,大多适配CPHA=0;时钟触发输出的器件,大多需要CPHA=1。最终模式是CPOL+CPHA组合,必须对照器件时序图确认。
表1 SPI模式对照表
|
模式 |
CPOL |
CPHA |
|
0 |
0 |
0 |
|
1 |
0 |
1 |
|
2 |
1 |
0 |
|
3 |
1 |
1 |
比起死记4个模式,理解器件为什么需要这个相位,更有价值。
九、与绝对值编码器的结合场景
回到前面线性编码器项目:74HC597采集多路位置传感信号,转换成串行数据流。数据载入寄存器之后,最高位立刻送到串行输出。
编码器位置值为10100110,载入完成瞬间串行输出=1,还没有任何时钟脉冲。主控必须在移位之前读取这个比特,否则首比特丢失,整个位置数据错位。这就是编码器接口经常需要“先读后时钟”的根源:传输开始前,数据已经就绪。
十、跳出SPI模式固化思维
很多SPI教程开篇直接罗列Mode0~Mode3,虽然参数没错,但容易掩盖核心问题:数据什么时候有效?只要先分清器件是“先读后时钟”还是“先时钟后读”,时钟相位的意义就一目了然。SPI模式不是随便选的软件参数,它只是用来让MCU的采样时序,匹配寄存器外设的输出时序。
十一、SPI外设额外注意事项
这套“数据有效时机”逻辑适用于绝大多数SPI外设和移位寄存器。但部分MCU的SPI外设,在标准CPOL/CPHA之外,还有额外时序选项。仅仅选对SPI模式,不一定保证通信稳定。输入延迟、输出延迟、空周期、时钟速率、外设特殊配置,都会影响通信。调试时,必须同时对照寄存器芯片规格书和MCU SPI外设手册。
十二、总结
多数场景下,SPI调试的核心不是时钟极性CPOL,而是时钟相位CPHA。相位决定采样动作发生在移位时钟边沿之前,还是之后。
74HC597就是典型例子:数据载入寄存器之后,首比特直接输出。在移位之前读取,才能保证数据不丢失。其他器件逻辑不同,部分器件只有时钟触发后,才会产生有效数据。
理解这个差异,就能看懂SPI相位参数的设计目的,也知道为什么模式选错会报错。不用死背4种SPI模式,拿到器件先看时序图,问自己一句话:数据是已经等着被读,还是要等时钟脉冲才会出来?这个问题,基本就能锁定接口配置方案。